Benchmark de INP en React: troceo, startTransition y scheduler.yield
Un clic durante un trabajo pesado en React esperó 299 ms en la versión síncrona y 330 ms con startTransition, pero 12–13 ms al trocear el trabajo.
Un usuario pulsa un botón que lanza un trabajo pesado: filtrar una lista grande, puntuar filas, construir un índice de búsqueda. Mientras ese trabajo ocupa el hilo principal, el siguiente clic espera, porque el navegador no puede atender la entrada ni pintar hasta que el trabajo termine. Interaction to Next Paint (INP) mide esa espera, y en pantallas de React con muchos datos suele ser la primera Core Web Vital que falla.
Las respuestas habituales son startTransition, trocear el trabajo con setTimeout, ceder el hilo con scheduler.yield() o usar una biblioteca que haga el troceo por ti. Yo mantengo una de esas bibliotecas, react-inp-chunker, así que quería datos, no afirmaciones. Este artículo recorre un benchmark pequeño que ejecuta el mismo trabajo de cinco formas y mide cuánto espera un clic hecho mientras ese trabajo está en marcha.
La configuración
La carga de trabajo puntúa 20.000 filas, con 30 rondas de hash de cadenas por fila, y después ordena los resultados y muestra los 25 mejores. Todas las versiones hacen exactamente el mismo trabajo. Solo cambia la planificación:
| Versión | Cómo se planifica el trabajo |
|---|---|
| Síncrona | Puntúa todas las filas dentro del manejador del clic. |
| Franjas con setTimeout | Franjas de 5 ms escritas a mano, cediendo el hilo con setTimeout(0). |
| startTransition | Envuelve la actualización de estado en una transición; la puntuación ocurre en el render. |
| react-inp-chunker | useChunkedTask(rows, scoreRow): franjas de 5 ms, cediendo con scheduler.yield(). |
| scheduler.yield | Franjas de 5 ms escritas a mano, cediendo con scheduler.yield(). |
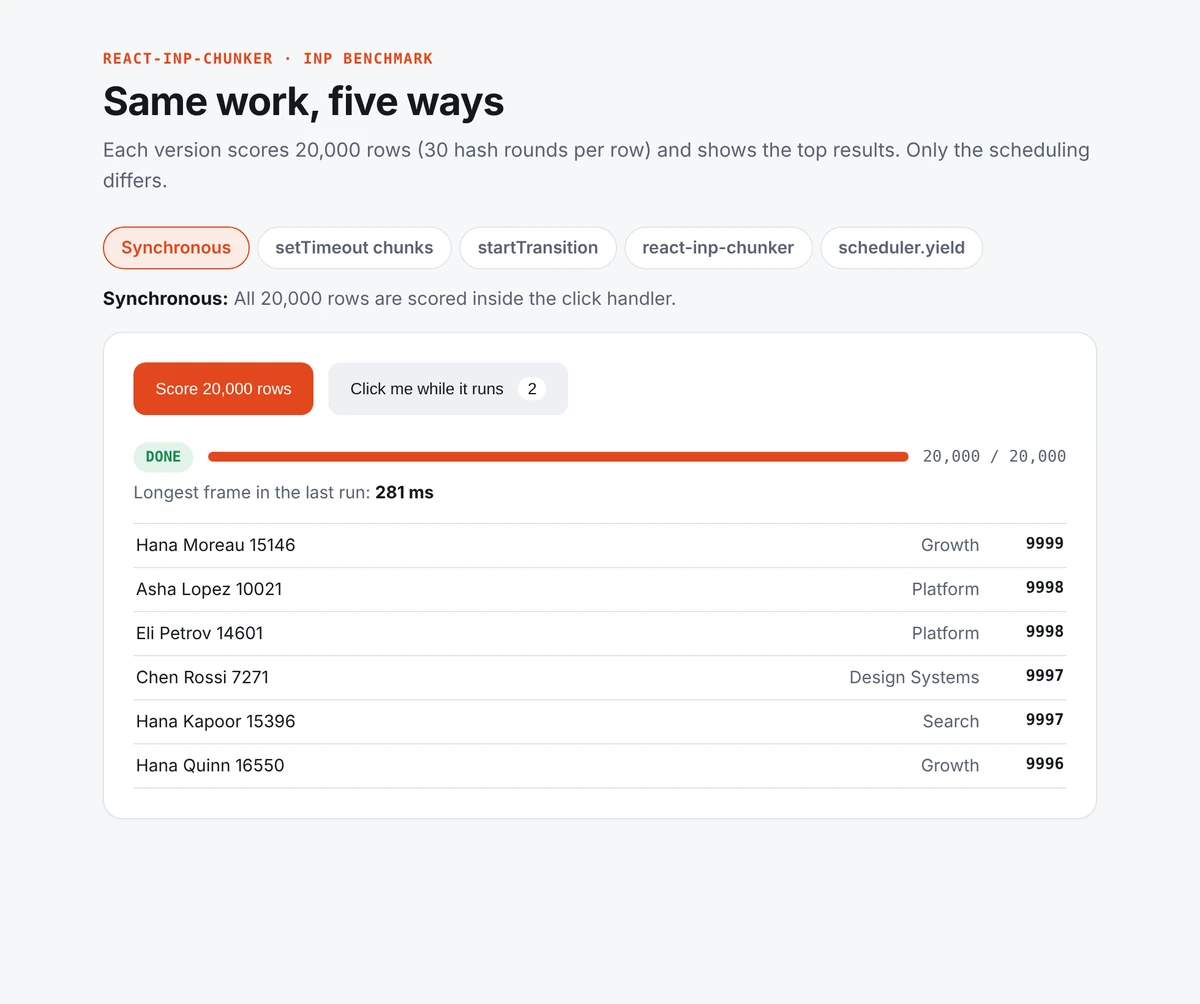
Cada ejecución pulsa Score 20,000 rows y, 50 ms después, pulsa un segundo botón mientras las filas todavía se están puntuando. Para ambos clics, la aplicación registra el tiempo desde el evento de clic hasta el siguiente frame de animación: el primer momento en que su respuesta puede pintarse. Es la demora que mide INP, registrada sin el umbral de 16 ms con el que informa la Event Timing API. La aplicación registra también el frame más largo de la ejecución y el tiempo total hasta que los resultados aparecen en pantalla.
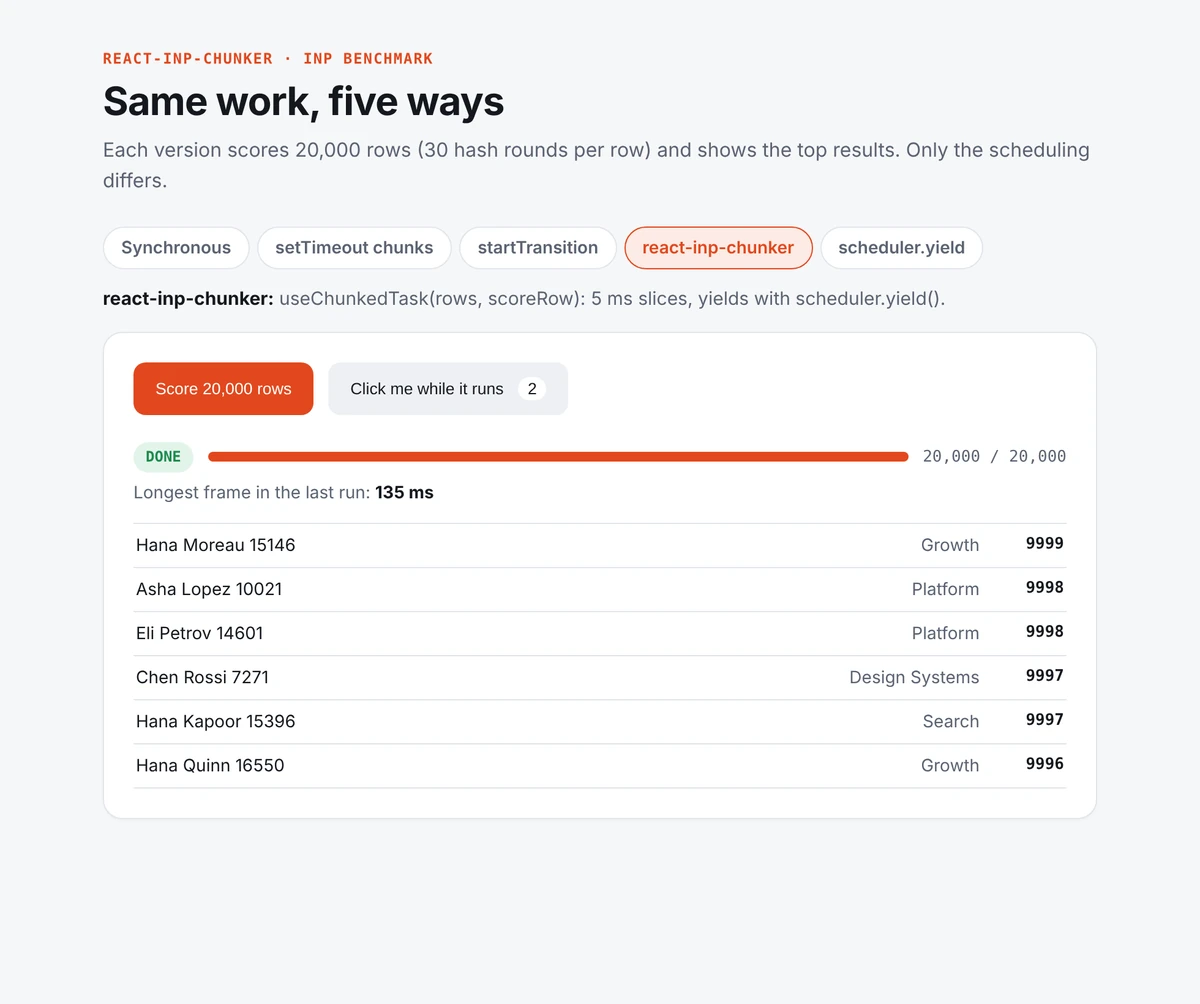
Los números proceden de Chromium 141 en modo headless, en una máquina virtual en la nube con 2 núcleos y la CPU ralentizada 4x: 30 ejecuciones por versión tras 3 de calentamiento. Los valores absolutos dependen de la máquina. La carpeta del benchmark contiene el código, el método y todas las muestras, para que puedas ejecutarlo en la tuya.
Resultados
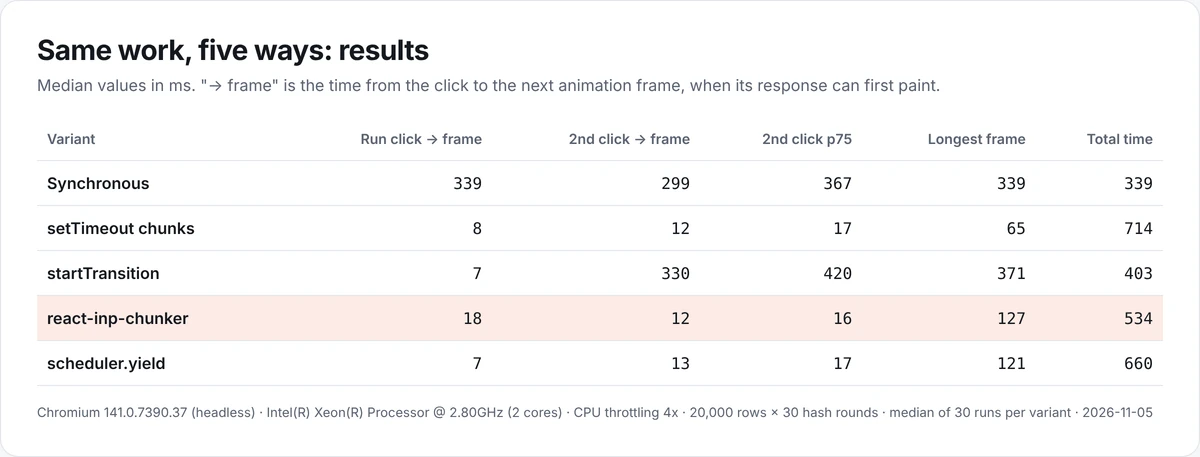
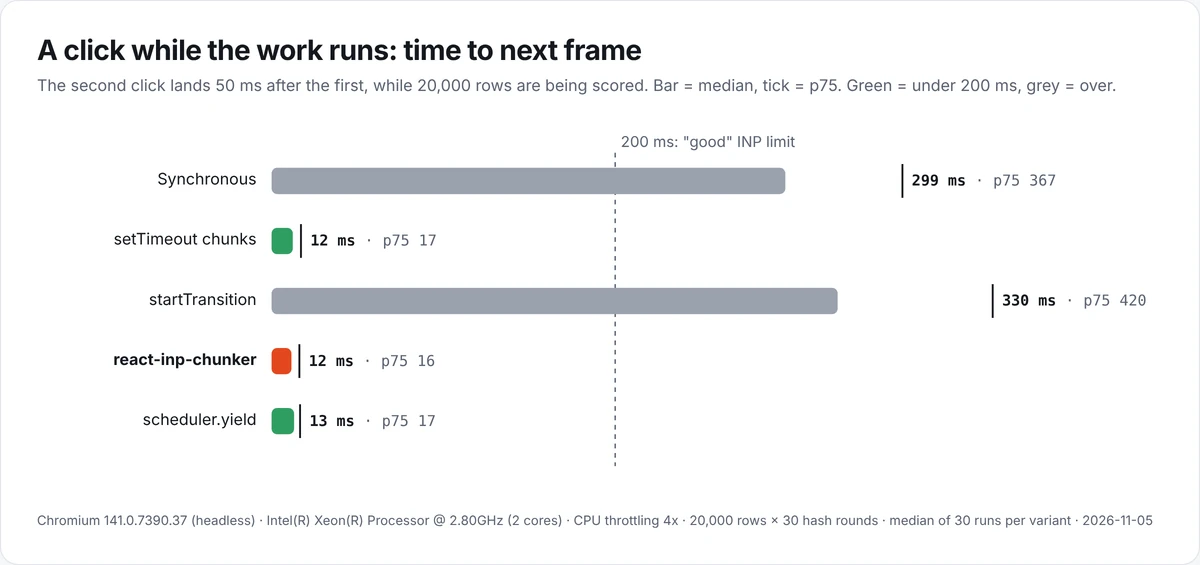
El hallazgo principal: un clic hecho mientras el trabajo se ejecuta esperó una mediana de 299 ms en la versión síncrona y de 330 ms con startTransition, ambas por encima del límite de 200 ms para un INP bueno. Las tres versiones troceadas mantuvieron ese clic en 12–13 ms, cerca de un solo frame.
Por qué startTransition no ayudó aquí
startTransition cumplió lo que promete con el primer clic. El clic que inicia el trabajo llegó al siguiente frame en una mediana de 7 ms, frente a 339 ms en la versión síncrona, porque React trata la actualización como no urgente y deja pintar primero al navegador.
El problema llega con el segundo clic. En esta versión, la puntuación se ejecuta durante el render, dentro de useMemo, que es como mucho código real calcula datos derivados. React puede interrumpir una transición entre componentes, pero no puede pausar a mitad del render de un componente. Un render que hace toda la puntuación es un único bloque largo de trabajo, y el clic que llega durante ese render lo espera entero: 330 ms de mediana y 420 ms en el p75.
Las transiciones ayudan cuando el coste se reparte entre muchos componentes, por ejemplo cuando un árbol grande se vuelve a renderizar tras cambiar un filtro. No dividen un cálculo costoso. Para eso, es el propio cálculo el que tiene que ceder el hilo.
La contrapartida: ceder el hilo cuesta tiempo total
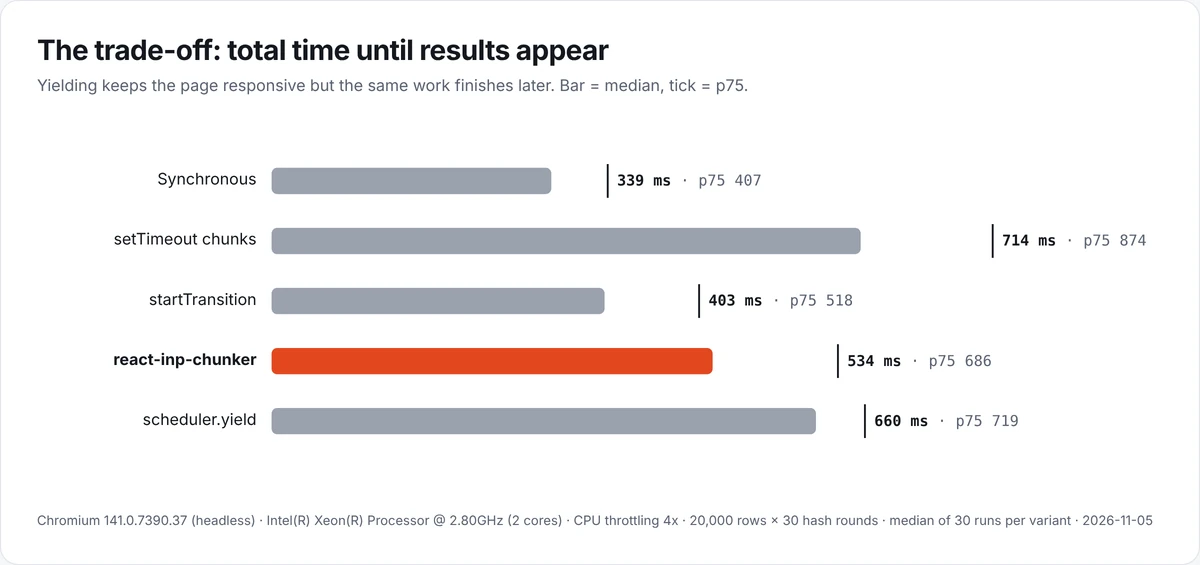
Ceder el hilo no es gratis. Cada franja devuelve el hilo principal al navegador, y el trabajo solo continúa cuando el navegador vuelve a programarlo, así que el mismo trabajo termina más tarde. La versión síncrona mostró sus resultados tras una mediana de 339 ms. Las versiones troceadas tardaron 534 ms con react-inp-chunker, 660 ms con scheduler.yield() escrito a mano y 714 ms con setTimeout.
setTimeout es la más lenta porque los navegadores limitan los temporizadores anidados: cuando hay varios niveles de anidación, setTimeout(fn, 0) espera al menos 4 ms. Con franjas de 5 ms de trabajo, una espera mínima de 4 ms tras cada franja se acumula rápido. scheduler.yield() está pensado para este caso: el trabajo se reanuda antes que otras tareas en cola.
La diferencia entre react-inp-chunker y scheduler.yield() escrito a mano parece grande en un gráfico de medianas, pero aquí está dentro del ruido entre ejecuciones: las ejecuciones individuales de ambas versiones se solapan ampliamente (consulta results.json). Este benchmark no demuestra que ninguna de las dos termine antes. Lo que sí respalda es una afirmación más acotada: la biblioteca ofrece la misma capacidad de respuesta que un bucle con scheduler.yield() escrito a mano, sin que tengas que escribir ni mantener ese bucle.
El frame más largo muestra un límite más. La ordenación final de 20.000 resultados sigue siendo un único bloque de trabajo, así que el frame más largo se queda en una mediana de 121 ms con scheduler.yield() y de 127 ms con react-inp-chunker; en la versión con setTimeout, la mediana fue de 65 ms. Trocear solo ayuda con el trabajo que troceas.
Qué usar en cada caso
- El trabajo pequeño no necesita nada. Si una actualización tarda unos pocos milisegundos, planificarla añade complejidad y tiempo total sin ningún beneficio. Mide primero: una tarea de más de 50 ms es una tarea larga.
- Saca los cálculos pesados del render. En la versión con
startTransition, el trabajo estaba enuseMemo, así que se ejecutaba durante el render, donde React no puede dividirlo. Lánzalo desde un manejador de eventos o un efecto y mantén el render barato. - Usa
startTransitionpara renders costosos, cuando el coste se reparte entre muchos componentes. - Trocea los bucles largos sobre datos. Cuando el trabajo es una función aplicada a muchos elementos, divídelo en franjas y cede el hilo entre ellas.
Una versión escrita a mano de ese bucle tiene este aspecto:
async function scoreInSlices(rows: readonly Row[]) {
  const scored: Scored[] = [];
  let index = 0;
  while (index < rows.length) {
    await scheduler.yield();
    const start = performance.now();
    while (index < rows.length && performance.now() - start < 5) {
      scored.push(scoreRow(rows[index]));
      index += 1;
    }
  }
  return scored;
}
Aún le faltan una alternativa para los navegadores sin scheduler.yield(), un estado de progreso para la interfaz, la cancelación y la limpieza cuando el componente se desmonta. Con react-inp-chunker, el mismo trabajo cabe en un hook:
import { useChunkedTask } from 'react-inp-chunker';

function ScoredRows({ rows }: { rows: readonly Row[] }) {
  // scoreRow runs once per row, in slices of up to 5 ms.
  const task = useChunkedTask(rows, scoreRow);

  if (task.isError) return <p role="alert">Couldn't score the rows.</p>;

  if (task.status !== 'done') {
    return (
      <progress
        value={task.processed}
        max={task.total}
        aria-label="Scoring rows"
      />
    );
  }

  return <ResultsTable scores={task.results} />;
}
El hook vuelve a renderizar con el progreso una vez por franja, no una vez por elemento, y cancela el trabajo cuando el componente se desmonta. Una nueva referencia del array rows reinicia la tarea, así que memoiza los arrays derivados. La documentación cubre la API completa y cuándo conviene otra herramienta, como un Web Worker.
Límites de este benchmark
- Una sola máquina. Una máquina virtual en la nube con 2 núcleos y la CPU ralentizada 4x. Tus números serán distintos, así que comprueba la comparación en tu propio hardware.
- Un solo navegador, en modo headless. Chromium 141 admite
scheduler.yield(). Los navegadores que no lo admiten usan una alternativa que esta ejecución no midió. - Una carga sintética. El hash de cadenas cuesta lo mismo en cada fila. El trabajo real varía de un elemento a otro y usa la memoria de otra manera.
- Números de laboratorio, no INP de campo. El benchmark mide del clic al siguiente frame en una ejecución controlada. El INP real procede de usuarios reales en dispositivos reales, mientras el resto de la página también está trabajando.
Para saber qué experimentan tus usuarios, recoge el INP en campo, por ejemplo con la biblioteca web-vitals, y evalúalo en el percentil 75, que es como se valoran las Core Web Vitals. Para probar el benchmark en un teléfono real, abre la build de preview en el dispositivo y usa la depuración remota de DevTools.
Ejecútalo tú mismo
El README del benchmark describe el método completo. Desde un clon del repositorio:
cd bench/inp-demo
npm install
npm run build
npm run preview          # keep running, http://localhost:4173/
En una segunda terminal:
npx playwright install chromium   # once
npm run measure                   # writes results/results.json and RESULTS.md
npm run report                    # writes the charts, table and screenshots
La configuración se hace con variables de entorno: RUNS (30 por defecto), WARMUP (3), CPU_RATE (4), WORK (30 rondas de hash por fila), PING_DELAY_MS (50) y HEADED=1 para ver las ejecuciones. El caso de estudio de react-inp-chunker explica por qué existe la biblioteca y cómo se prueba.